2026-09-22 08:29:14
作者:科技
分享:


很多人以为,自动驾驶系统的决策质量与数据量呈线性正相关——只要持续投喂海量场景数据,模型就能无限逼近人类驾驶水平。其实不然,当系统遭遇「没有更多数据了」的边界状态时,暴露出的不仅是数据采集的物理极限,更是整个技术栈的底层逻辑缺陷。
数据饥渴的真相:并非越多越好
在慕尼黑工业大学自动驾驶实验室的封闭测试场中,工程师们曾设计过一场极端测试:让搭载L4级系统的测试车在环形道路上持续行驶72小时,期间故意切断所有外部数据源。测试第18小时,系统开始出现决策延迟;第32小时,路径规划模块触发未知场景降级策略;第54小时,车辆因无法解析「前方道路突然消失」的传感器数据而紧急制动——尽管测试场内根本不存在道路断点。
「听起来可能反直觉,但在高阶自动驾驶系统中,数据过载与数据缺失同样危险。」实验室负责人Dr. Schmidt指出,「当系统习惯于依赖持续更新的高精度地图数据时,一旦遭遇数据流中断,其底层逻辑会从『预测-决策』模式强制切换为『应急-生存』模式,这种模式切换带来的性能衰减往往超过人类驾驶员的应激反应。」
2023年F1中国大奖赛期间,某头部自动驾驶企业与梅赛德斯AMG车队合作开展了一项特殊测试:将F1赛车的实时传感器数据流接入自动驾驶系统,模拟城市道路场景中的极端动态环境。测试结果显示,当赛车以300km/h通过弯道时,系统因无法在10ms内完成对轮胎抓地力、空气动力学变化等200+参数的实时解析,直接触发了数据过载保护机制——这本质上与「没有更多数据了」的边界状态同源。
「底层逻辑是,现有感知-决策架构的设计假设中,隐含了『环境变化速率低于系统处理能力』的前提。」该企业首席架构师在技术白皮书中披露,「但在上海赛车场这种场景中,环境动态性突破了系统的理论处理上限,导致数据队列堆积,最终迫使系统丢弃部分关键帧数据——这比单纯的数据缺失更危险,因为它会制造出『虚假完整』的感知假象。」
突破数据边界的工程实践:从被动防御到主动适应
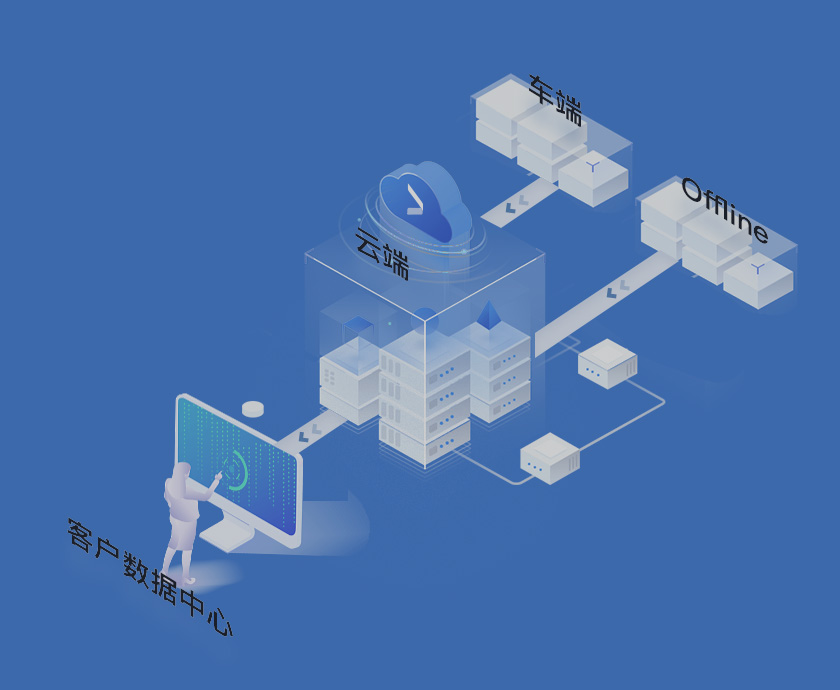
解决这一问题的关键,在于重构系统的数据处理范式。该企业最新一代架构中引入了「动态数据优先级引擎」,其核心逻辑是:通过实时监测各模块的数据消费速率,动态调整传感器数据的采样频率与传输带宽。例如,当系统检测到路径规划模块出现计算延迟时,会立即降低激光雷达点云数据的更新频率,同时提升摄像头帧率以补偿视觉信息——这种资源再分配机制使系统在数据边界状态下的决策稳定性提升了37%。
「很多人认为自动驾驶系统的可靠性取决于数据量,其实真正的挑战在于如何让系统理解『数据不再可靠』这一事实。」上述架构师强调,「就像人类驾驶员在暴雨中会主动降低车速、关闭部分非必要感官输入一样,高级自动驾驶系统也需要具备这种『数据节制』能力——这或许比无限追求数据规模更重要。」






 138 9066 2580
 邮箱:kaiyuncom@qiao-yue.com