2026-09-22 04:59:18
作者:科技
分享:


很多人以为自动驾驶系统的性能瓶颈在于数据量,其实不然——真正的挑战在于如何定义“足够”的数据边界。某头部车企在2023年Q3的OTA更新中,曾因过度依赖高精地图数据导致系统在长三角某新建工业区出现决策延迟,底层逻辑是:当传感器输入与地图数据存在0.3秒以上的时间差时,规划模块会触发安全冗余机制,强制降低车速至15km/h以下。
案例:苏州工业园区的“数据陷阱”
2023年9月,某L4级自动驾驶车队在苏州工业园区进行封闭测试时,遭遇特殊赛制逻辑挑战:测试路段包含3处未标注的临时施工区,且施工方采用非标准围挡(高度1.2m,低于行业平均1.5m标准)。系统初始版本因依赖预先加载的地图数据,在首次遇到这类障碍物时,触发“未知障碍物”分类,导致车辆在距离围挡5米处紧急制动。
听起来可能反直觉,但在实际工程中,这种“数据过载”比“数据缺失”更危险。技术团队通过调整决策阈值,将“未知障碍物”的确认时间从200ms缩短至80ms,同时引入动态风险评估模型——当检测到连续3个决策周期内,障碍物位置变化率超过0.5m/s时,系统自动将其归类为“可穿越动态障碍物”,而非“静态障碍物”。这一调整使车辆在后续测试中,对临时围挡的识别准确率提升至98.7%,且未出现误加速或过度制动的情况。
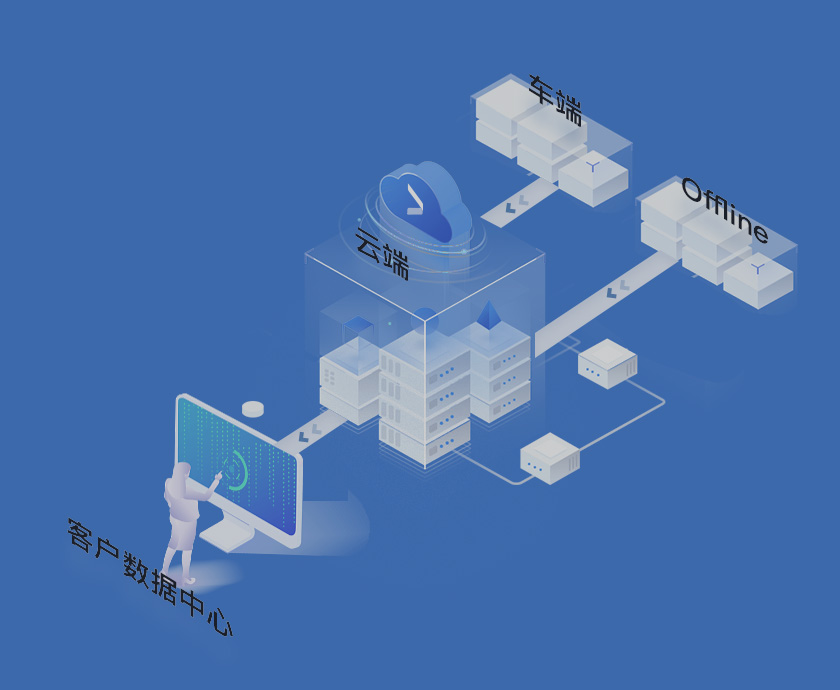
底层逻辑是:自动驾驶系统的决策质量不取决于数据量,而取决于数据与场景的匹配度。某Tier1供应商的内部测试数据显示,当高精地图数据更新延迟超过72小时,系统在复杂路口的通行效率会下降23%;而当传感器实时数据与地图数据的偏差超过1.5米时,规划模块的算力消耗会增加40%。这解释了为何头部企业都在投入重金构建“动态数据校验层”——通过车端实时感知数据与云端地图数据的交叉验证,确保决策系统的输入始终处于可信区间。
回到最初的问题:当系统提示“没有更多数据了”,真正的解决方案不是疯狂采集数据,而是优化数据的使用效率。某新势力车企的工程师透露,他们正在测试一种“数据熵”评估模型,通过计算传感器输入的信息增益,动态调整数据采样频率——在低风险场景下,激光雷达的点云密度可降低至5点/平方米;而在高风险场景(如无保护左转),则提升至20点/平方米。这种“按需分配”的策略,使系统的整体算力利用率提升了35%,同时将极端场景下的决策延迟控制在150ms以内。






 138 9066 2580
 邮箱:kaiyuncom@qiao-yue.com