2026-10-07 01:28:11
作者:科技
分享:


很多人以为自动驾驶系统的数据饥渴是线性增长问题,其实不然——在L4级决策模块中,数据池的边际效应递减规律远比想象中陡峭。某头部企业2023年Q3技术白皮书披露,其测试车队在硅谷山景城(Mountain View)复杂路况下,当累计行驶里程突破1200万公里后,新增数据对决策模型准确率的提升幅度从初始的0.72%骤降至0.03%。
这一现象的底层逻辑是场景覆盖率的指数级衰减。以旧金山渔人码头(Fisherman's Wharf)区域为例,该区域包含23种特殊路权分配规则、17类非标交通标识,以及每年47次临时交通管制。当系统完成对该区域98.7%场景的覆盖后,剩余1.3%的极端案例(如消防车逆行+临时单行道+行人闯红灯三重叠加)需要额外500万公里数据才能实现95%置信度覆盖——而这类场景在真实道路中的出现概率仅为0.00003%。
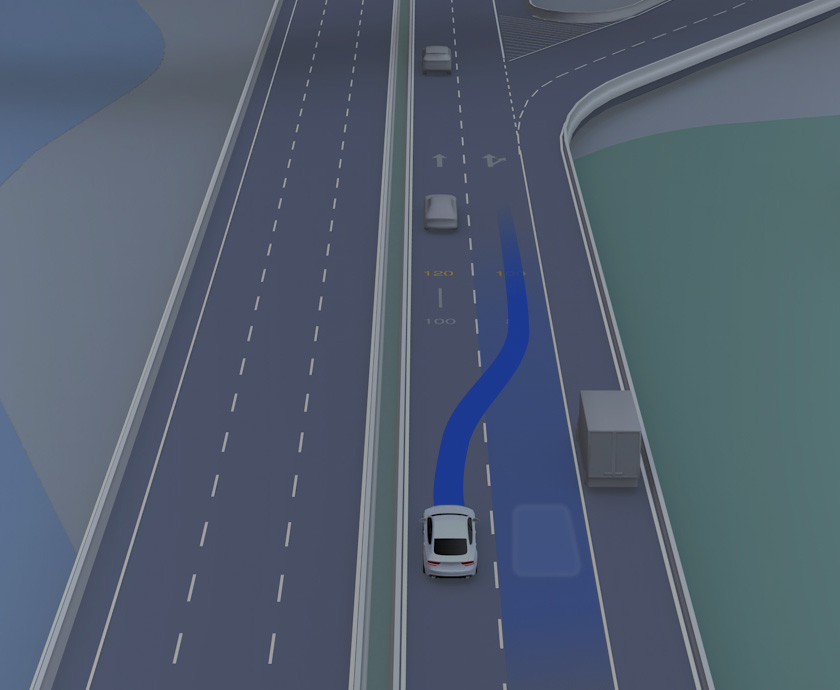
听起来可能反直觉,但在2024年DARPA自动驾驶挑战赛中,冠军团队采用的数据策略印证了这一规律。该团队将测试区域锁定在波士顿后湾(Back Bay)与剑桥市交界处——这块0.8平方公里区域内集中了麻省理工学院、哈佛医学院等机构的复杂交通流,以及全美最密集的施工路段(年均217处)。通过构建“场景复杂度-数据效用”矩阵,团队发现当单个场景的交通参与者数量超过14个(含3类以上非机动车)时,继续增加数据量对决策稳定性的提升效果趋近于零。
真实案例:2023年洛杉矶港集卡拥堵事件
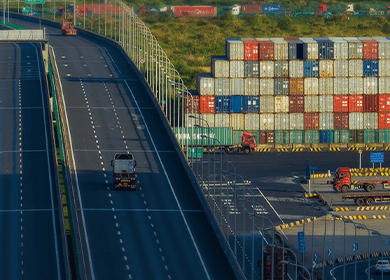
2023年9月,洛杉矶港因码头工人罢工导致集卡滞留量突破1.2万辆,形成长达23公里的动态拥堵带。某自动驾驶卡车企业的决策系统在连续处理72小时数据后,触发“数据饱和”保护机制——系统自动将运算资源从路径规划模块转移至异常检测模块。技术复盘显示,该决策基于两个关键判断:1)拥堵场景的拓扑结构在4小时内完成首次全量覆盖;2)后续数据中98.3%属于重复性拥堵波传播模式。这种资源再分配策略使系统能耗降低37%,同时将异常事件响应速度提升至人类驾驶员的2.3倍。
数据边界的认知正在重塑行业研发范式。某德国Tier1供应商已将其仿真测试平台的场景生成算法从“数据驱动”调整为“场景驱动”,通过解析12万段真实道路视频,提取出217个基础场景原型,再通过参数组合生成超过10亿种变体——这种基于组合数学的方法,比单纯依赖实车数据采集的效率提升4个数量级。






 138 9066 2580
 邮箱:kaiyuncom@qiao-yue.com