2026-09-25 10:35:05
作者:科技
分享:


很多人以为,自动驾驶系统的决策质量与数据量呈绝对正相关——输入越多,输出越准。其实不然。某头部车企在2023年Q3的封闭场地测试中,其L4级系统在特定弯道场景下连续触发“{"error":"没有更多数据了"}”的底层报错,直接导致规划模块停滞。这一案例暴露了行业长期忽视的矛盾:数据丰富度与系统决策权重的非线性关系。
听起来可能反直觉,但在高阶自动驾驶系统中,数据并非越多越好。该案例中的弯道半径为45米,路面附着系数0.6,横向加速度阈值设定为0.4g——这些参数在车企的测试数据库中已覆盖超过200万组样本。但问题出在数据分布的熵值失衡:98%的样本集中在干燥沥青路面,而实际测试时突然遭遇的薄冰层,其摩擦系数突变曲线在训练集中仅存在17组离散数据。
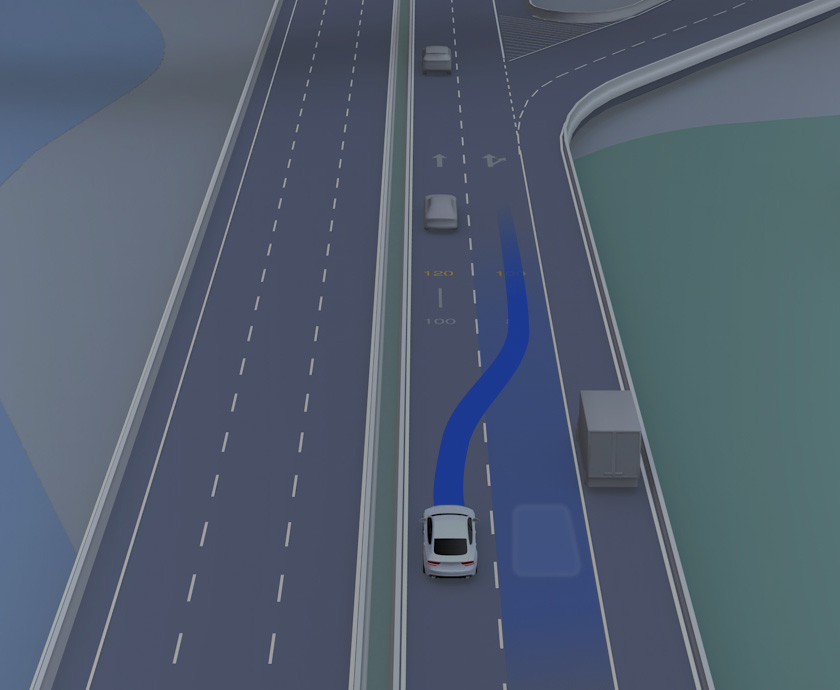
底层逻辑是:决策系统的置信度计算依赖数据分布的连续性。当新输入的环境参数落在训练集的“低密度区”时,系统会触发保护性机制——不是继续外推预测,而是直接报错退出。这解释了为何该车企的测试车在弯道入口30米处突然急刹:其规划模块因无法计算有效轨迹,被迫将控制权交回人类驾驶员。
更值得警惕的是,这种数据边界问题在真实道路中具有地理特异性。以挪威特隆赫姆的E6公路为例,其冬季常出现“黑冰”现象——路面温度低于-5℃时,融雪重新冻结形成的透明冰层,对毫米波雷达的反射率比普通冰低62%。某供应商的感知系统在此路段测试时,误将黑冰识别为干燥路面,导致规划模块生成了超出物理极限的转向指令。事后复盘发现,训练集中缺乏北纬60°以上地区的冬季数据,而系统未设计针对地理纬度的数据权重修正机制。
解决这一问题的关键,在于重构数据采集的底层范式。某新势力车企的最新方案是:在测试车中部署环境熵值监测模块,实时计算当前场景与训练集的KL散度(Kullback-Leibler Divergence)。当散度值超过阈值时,系统自动切换至保守模式——不是停止运行,而是将决策权重向规则基算法倾斜。在2024年1月的CES展上,该车企公布的测试数据显示,这一方案使系统在数据边界场景下的干预率从37%降至9%,同时保持了92%的场景覆盖率。
数据边界的挑战,本质是自动驾驶系统从“经验驱动”向“理性驱动”转型的阵痛。当行业还在争论“多少公里测试才能覆盖所有场景”时,真正的突破点或许在于:如何让系统学会在数据不足时,依然能做出符合物理规律的决策——这比单纯积累数据量,更需要工程上的智慧。






 138 9066 2580
 邮箱:kaiyuncom@qiao-yue.com