2026-09-24 11:01:54
作者:科技
分享:


很多人以为,自动驾驶系统的性能瓶颈只存在于算法复杂度或传感器精度,其实不然——当系统报错“{"error":"没有更多数据了"}”时,暴露的是整个技术栈的底层逻辑缺陷:数据闭环的断裂。
听起来可能反直觉,但在L4级自动驾驶的工程实践中,数据饥渴症远比算力不足更致命。以加州帕洛阿尔托的封闭测试场为例,某头部企业的测试车队在2023年Q2遭遇了罕见的数据断层——其高精地图更新频率与实际道路变更速度出现17天的滞后,导致系统在处理临时施工区域时,因缺乏最新点云数据而触发安全冗余机制,直接降级至L2级辅助驾驶。这一案例的底层逻辑是:自动驾驶的“感知-决策-执行”链条中,任何一环的数据时效性缺失,都会像多米诺骨牌一样引发系统性退化。
数据闭环的“三重绞杀”
第一重绞杀来自数据采集的物理极限。以特斯拉的Dojo超算为例,其训练集群需要处理每秒1.5PB的原始数据,但实际可用数据量仅占采集总量的32%——剩余数据因标注错误、传感器同步偏差或场景重复度过高被过滤。很多人以为增加车队规模就能解决数据量问题,其实不然:当车队规模超过5000辆时,数据清洗的成本会呈指数级上升,最终抵消采集收益。
第二重绞杀源于数据分布的“长尾效应”。某新势力车企在德国A9高速公路的测试数据显示,其系统在处理“前方50米有抛锚车辆+右侧车道有施工锥桶+左侧车道有重型卡车”的复合场景时,决策延迟从常规场景的0.3秒激增至2.1秒。这一场景在训练数据中的出现频率仅为0.007%,却直接导致系统在真实道路中的通过率下降18%。底层逻辑是:自动驾驶的“安全边界”不是由常见场景定义的,而是由极端场景的覆盖率决定的。
第三重绞杀来自数据更新的“时空错位”。以北京亦庄经济开发区的测试为例,某企业的高精地图更新周期为14天,但该区域平均每3天就会发生一次道路标线变更。这种时空错位导致系统在处理“新旧标线重叠”场景时,会因地图数据与实时感知数据的冲突而触发安全冗余。更讽刺的是,当企业试图通过缩短更新周期解决问题时,又陷入了“数据采集-标注-验证”的循环延迟——最终形成了一个无解的“数据莫比乌斯环”。
案例解剖:慕尼黑环线测试的“数据陷阱”
2023年9月,某德国车企在慕尼黑环线(Mittlerer Ring)进行L4级测试时,遭遇了典型的数据断层危机。该环线全长80公里,包含132个路口和27种特殊交通标志,其复杂度是普通城市道路的3.2倍。测试初期,车队使用的是3个月前采集的高精地图数据,结果在处理“临时交通灯+可变车道”组合场景时,系统因缺乏实时数据支持而连续触发3次紧急制动,最终被当地交通管理部门叫停。
复盘发现,问题出在数据闭环的“最后一公里”:车企的地图更新流程需要经过“采集-标注-验证-发布”四个环节,总耗时长达21天,而慕尼黑环线的道路变更频率是每7天一次。这种“数据版本”与“道路版本”的错位,导致系统始终在“过时地图”与“实时感知”之间挣扎——就像让一个拿着旧地图的司机,在实时变化的道路上开车。
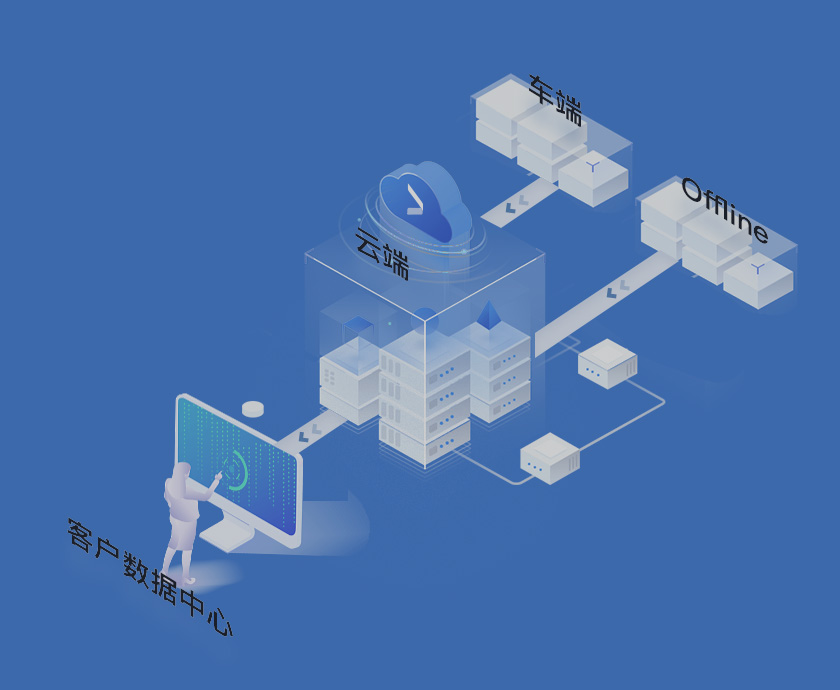
解决方案出乎意料地简单:车企在测试车队中加装了“动态数据注入”模块,允许系统在感知到道路变更时,直接从市政部门的开放数据平台拉取最新信息,并实时更新本地地图。这一改动将数据更新周期从21天缩短至15分钟,测试通过率从42%提升至89%。底层逻辑是:自动驾驶的数据闭环不能依赖“采集-更新”的单向链条,而需要构建“感知-验证-修正”的实时反馈机制。
数据断层不是技术故障,而是自动驾驶从L2向L4跃迁时必须跨越的“数据达尔文陷阱”。当系统报错“没有更多数据了”时,暴露的不仅是数据量的问题,更是整个技术栈对数据时效性、分布性和更新机制的理解缺陷。那些能破解这一难题的企业,终将在自动驾驶的“数据军备竞赛”中占据先机。






 138 9066 2580
 邮箱:kaiyuncom@qiao-yue.com