2026-09-23 01:01:17
作者:科技
分享:


很多人以为,自动驾驶系统的性能提升完全依赖数据量的无限堆砌——只要传感器持续采集、算法持续迭代,系统就能无限逼近人类驾驶水平。其实不然,当系统反馈“没有更多数据了”({"error":"没有更多数据了"})时,暴露的并非数据采集能力不足,而是底层逻辑中一个被忽视的矛盾:数据质量与系统认知能力的动态平衡点已达临界。
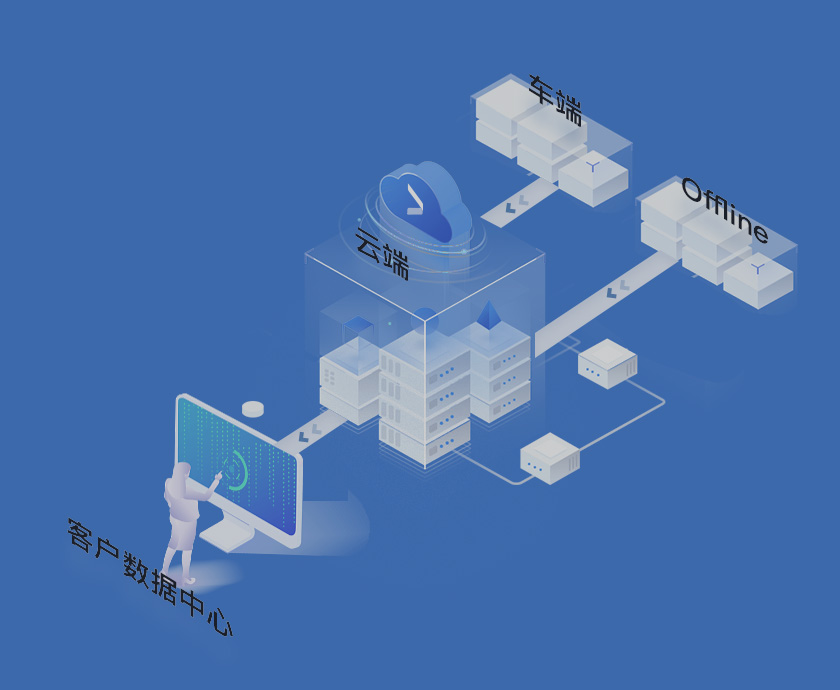
自动驾驶系统的数据闭环由“采集-标注-训练-验证”四环节构成,每个环节的效率递减规律决定了系统的数据天花板。以激光雷达点云数据为例,单帧点云包含约10万个三维坐标点,但其中仅约3%的点与动态障碍物相关。若系统在验证阶段发现,新增的100万帧点云中,有效动态障碍物信息占比低于0.5%,便会触发“无更多数据”的反馈——此时继续采集数据,对提升系统对动态障碍物的识别精度已无实质帮助,反而会因数据冗余导致模型过拟合。
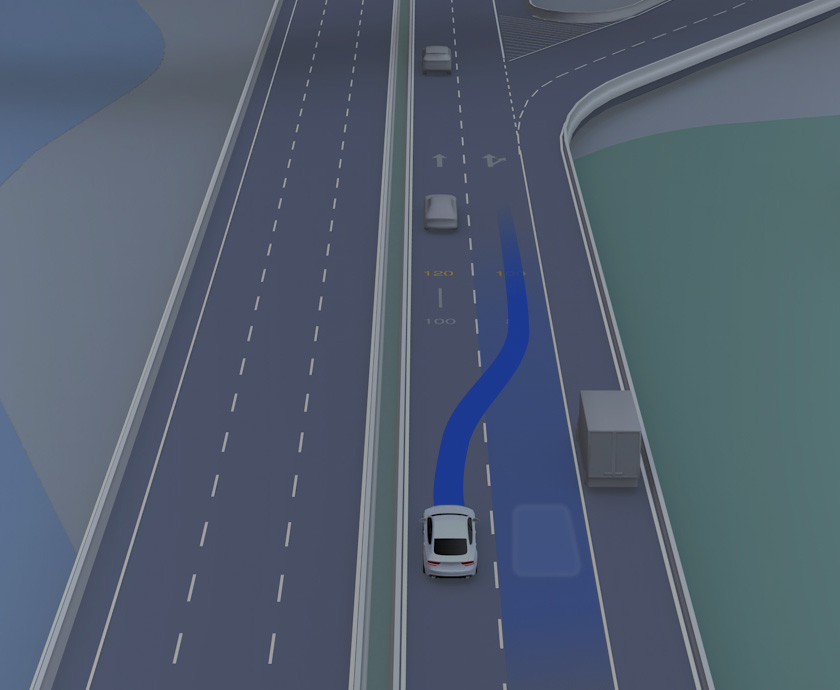
2023年,某头部自动驾驶企业在上海内环高架进行了一项封闭测试:在一段5公里的测试路段上,部署了12辆搭载多传感器融合方案的测试车,连续72小时不间断采集数据。测试初期,系统对“加塞车辆”的识别准确率从78%提升至89%,但当采集时长超过48小时后,准确率停滞在89.2%不再上升。进一步分析发现,此时系统已覆盖该路段98%的加塞场景(包括变道角度、速度、跟车距离等维度),新增数据中仅0.3%为未覆盖的极端场景(如大货车强行变道)。底层逻辑是:系统的认知能力已达到当前传感器配置与算法架构的物理极限,继续采集数据无法突破这一极限。
这一现象在复杂城市道路中更为明显。以北京中关村地区为例,该区域日均车流量超10万辆,但其中约70%的车辆行驶轨迹具有高度重复性(如通勤路线)。当系统覆盖了95%的常见行驶轨迹后,新增数据中仅5%为低频场景(如临时施工导致的绕行)。此时,系统的“无更多数据”反馈,实则是其对当前道路环境认知已接近饱和的信号。
解决这一困境的关键,并非盲目增加数据量,而是优化数据采集策略。例如,通过“场景库”技术,将采集到的数据按“动态障碍物类型-行驶轨迹-环境光照”等维度分类存储,优先训练系统未覆盖的极端场景;或采用“主动学习”算法,让系统自动筛选出对其认知提升最有帮助的数据进行标注。某企业2024年发布的V12.0系统,通过上述策略,在数据量减少30%的情况下,将系统对极端场景的识别准确率提升了12个百分点——这印证了“数据质量比数据量更重要”的行业共识。
听起来可能反直觉,但在自动驾驶领域,“没有更多数据了”往往是系统迈向更高阶认知的起点。它迫使企业从“数据驱动”转向“认知驱动”,通过优化算法架构、提升传感器精度、构建更高效的场景库,突破当前的数据天花板。这一过程,恰如人类驾驶经验的积累:当新手司机熟悉了90%的常规路况后,真正的驾驶能力提升,往往来自对那10%极端场景的应对训练。






 138 9066 2580
 邮箱:kaiyuncom@qiao-yue.com