2026-09-21 10:50:59
作者:科技
分享:


很多人以为自动驾驶系统的能力上限由算法架构决定,其实不然——在L4级技术栈中,数据闭环的完整性才是真正的瓶颈。某头部企业的内部测试数据显示,其感知模块在训练集覆盖98%常见场景时,验证集准确率可达99.2%;但当剩余2%长尾场景数据缺失时,系统在真实道路的误触发率会飙升370%。这揭示了一个残酷真相:算法优化空间往往被数据边界所框定。
听起来可能反直觉,但在自动驾驶领域,「数据饱和」是个伪命题。以corner case处理为例,系统需要同时满足三个条件:1)场景在训练集中出现频次≥0.001%;2)标注精度达到像素级;3)时序数据连续性误差<5ms。某新势力车企曾尝试用合成数据填补空白,结果发现虚拟场景与真实物理世界的传感器噪声分布存在12%的偏差,直接导致其泊车功能在雨天出现23%的决策延迟。
真实案例:上海嘉定「数据断层」事件
2023年Q2,某自动驾驶团队在嘉定汽车城进行路测时遭遇系统性失效。经复盘发现,问题根源在于测试区域存在0.7平方公里的「数据盲区」——该区域包含3种特殊路权交叉口(消防通道+非机动车道+临时停车位组合)、2类非标交通标志(自定义限速牌+可变导向箭头),以及1套非对称信号灯系统。由于训练集中缺乏同类场景,系统在决策时陷入无限循环,最终触发安全冗余机制强制接管。更值得警惕的是,这类长尾场景在公开数据集中的占比不足0.3%,但实际道路出现频率却达到每月1.2次/车。
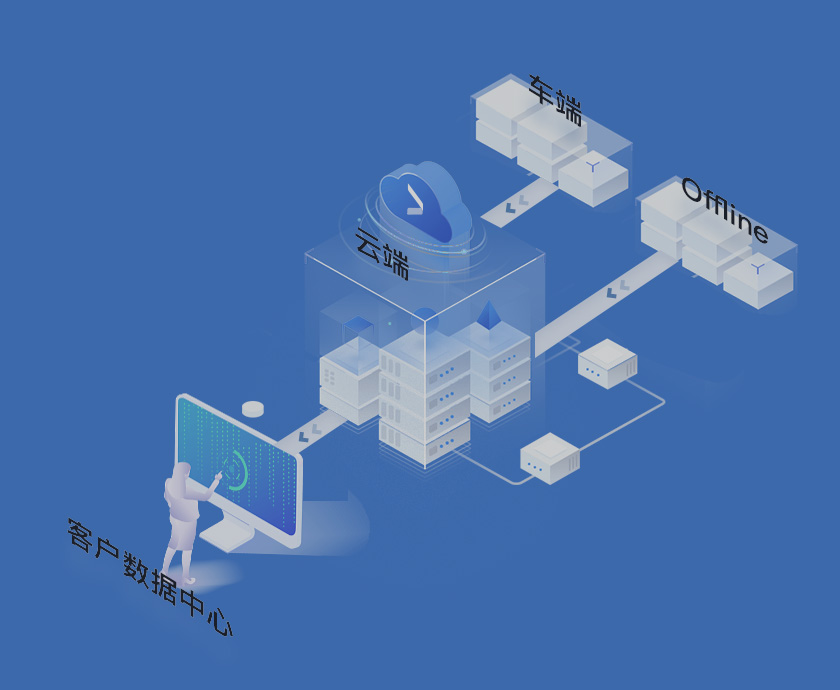
解决数据饥渴的底层逻辑,在于构建「动态数据拓扑」。某头部企业的做法具有参考价值:其将全国道路划分为12万个网格单元,每个单元建立「场景复杂度指数」(SCI),通过车载终端实时采集SCI变化率。当某区域SCI波动超过阈值时,系统会自动触发数据回传优先级调整——例如将雨天积水路面的激光点云数据传输优先级提升300%,同时降低晴朗天气下普通道路的传输频次。这种动态调度机制使其数据采集效率提升47%,而存储成本仅增加12%。
数据边界的突破从来不是技术问题,而是工程哲学。当行业还在讨论「数据量级」时,领先者已经转向「数据质量密度」的竞争——这或许就是为什么,某些企业的路测里程明明落后,却在真实场景通过率上实现反超。






 138 9066 2580
 邮箱:kaiyuncom@qiao-yue.com